匿名一周骗了全世界,10万张国产芯片才是真底牌
所有人都在猜牛来是谁。
答案揭晓了,智谱,意料之中。但大家可能猜错了真正值得关心的问题。
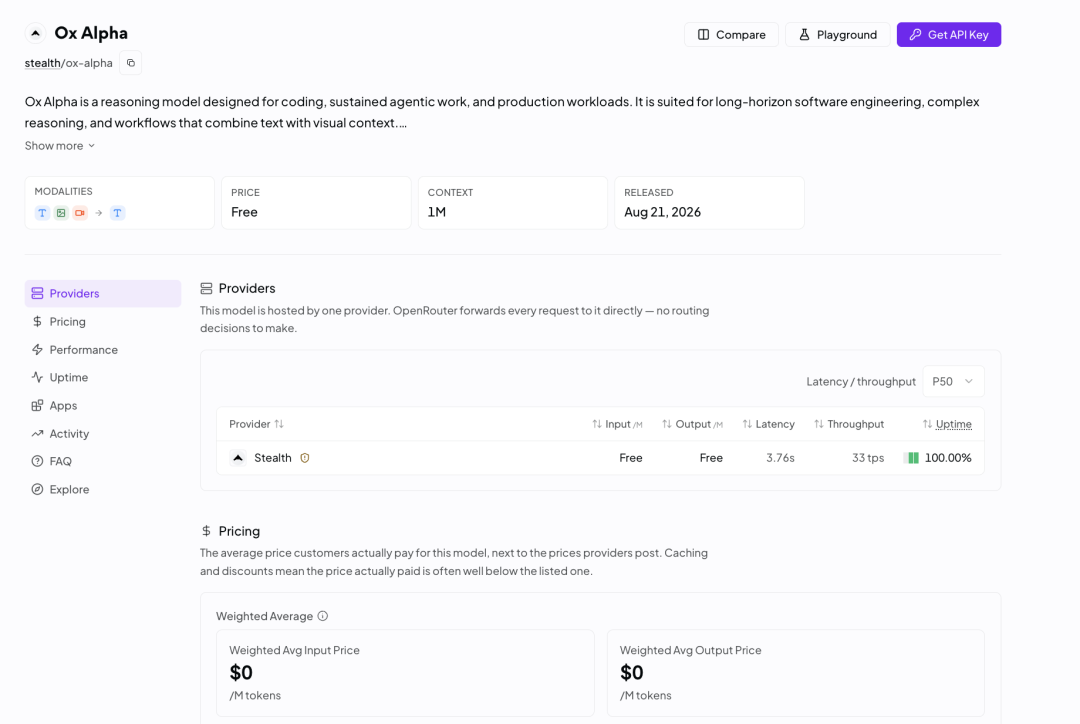
牛来这个模型确实猛,AA综合智能指数57分,跟Anthropic最受欢迎的Claude Opus 4.8打平。价格只有人家的四十分之一。在OpenRouter上一周拿走近20%的token份额,排名第一。单日处理tokens达62T,刷新平台历史纪录。
这些数字都很漂亮。但唐杰8月27日凌晨在X上发的那条帖子里,最值得反复读的一句话不是分数,不是排名,而是六个字。
"纯国产芯片驱动。"
一周时间线,从匿名到揭晓
先把时间线捋清楚。
过去一周全网都在猜爹,从谷歌到xAI到Anthropic,猜了一圈。结果又是中国公司,OpenRouter上Stealth模型五次有五次都是中国厂商。
但身份揭晓不是最炸的部分。
真正的底牌
GLM-5.3-Flash这个模型本身确实强。3200亿总参数,只激活180亿。稀疏注意力加线性注意力的混合架构,把注意力计算量降了3倍,KV缓存缩小4.4倍。这些数字对搞技术的人来说很有冲击力。
但模型是产品。产品可以被追赶、被复制、被超越。今天你57分,下个月别人就58分了。这个行业的节奏就是这样,旗舰模型几乎以月为单位更新。
芯片不一样。
智谱透露,"牛来"测试期间的全部线上流量,以及GLM-5.3-Flash发布后的线上服务,均由10万张国产芯片承载。
10万张。
这不是实验室里的跑分测试,不是被精心控制的小规模demo。这是在OpenRouter这个全球最大的模型聚合平台上,面对全球真实用户、真实负载、真实流量的大规模在线服务。日处理tokens达62T,服务性能比初始基线提升了3倍,硬件效率和单Token成本达到了与主流英伟达GPU相当的水平。
之前关于"每天500万亿Token的算力供给从哪来"的争论,到这里有了第一个实打实的答案。
据《科创板日报》记者了解,这批国产芯片或来自华为、海光、摩尔线程。
三个值得细想的维度
第一,性能-价格悖论
GLM-5.3-Flash每百万token输入0.8元、输出2.8元。对比一下,Claude Opus 4.8每百万token输入约35元、输出约175元。同一个分数段,价格差了40倍。
Claude Opus 4.8
AA指数57分
输入约35元/百万token
输出约175元/百万token
闭源,依赖英伟达GPU
GLM-5.3-Flash
AA指数57分
输入0.8元/百万token
输出2.8元/百万token
MIT开源,国产芯片驱动
这个价格不是靠烧钱补贴做出来的。是架构层面的重构。稀疏注意力与线性注意力混合,线性注意力以递归机制捕获局部依赖,注意力计算量降了3倍,KV缓存缩小4.4倍。同时用30T Token的多模态预训练语料打底,让更少的计算资源实现更强的性能。
坦率地讲,这不是价格战,是效率战。
第二,国产芯片的"隐身测试"
为什么要匿名发布?很多人以为是为了制造悬念、做营销。但结合芯片这个信息再想一层,答案可能不一样。
如果一开始就说"这是我们用国产芯片跑的新模型",会发生什么?第一反应大概率不是"好厉害",而是"国产芯片能行吗"。先入为主的偏见会拉低所有人的预期基线。用户会带着"这是国产芯片,肯定差点意思"的心态去测试,每一个不够完美的地方都会被放大。
匿名测试剥离了标签,让模型只靠表现说话。结果是什么?所有人都在猜它来自哪家国际大厂。谷歌研究员猜是Gemini。社区的共识是"这水平不可能是中国公司做的"。
等到揭晓的那一刻,10万张国产芯片已经在全球真实负载下跑了一整周,数据摆在那里。这时候再质疑"国产芯片能不能行",已经太晚了。因为事实已经发生了。
第三,匿名策略的进化
这已经不是智谱第一次这么玩了。今年春节前,OpenRouter上出现过一款叫Pony Alpha的匿名模型,性能突出被业界竞猜,后来被证实是智谱的GLM-5。加上Ox Alpha,第二次了。
而且不只是智谱。OpenRouter上的Stealth模型,五次有五次都是中国公司。
这个策略的底层逻辑是什么?能力到了,匿名才是一种选择。如果你的模型不够强,匿名发布只会石沉大海,没人会关心一个不知道哪来的弱模型。只有当你有信心模型能打到第一梯队,匿名才会产生悬念和讨论。
能力不够的时候,匿名是躲。能力够了,匿名是攻。
主流视角漏掉了什么
过去48小时,几乎所有中文媒体都在写同一件事,智谱认领了牛来,GLM-5.3-Flash性能比肩Opus 4.8,价格只有四十分之一。
都对。但都漏了一个层次。
媒体关注的焦点是"谁做了什么模型"。这是一个产品层面的叙事。但这件事真正改变格局的部分,在基础设施层面。
10万张国产芯片,首次大规模集体出海,直接服务全球真实负载。这个"首次"比模型性能打平Opus 4.8重要得多。
| 对比维度 | 模型层面 | 芯片层面 |
|---|---|---|
| 事件 | AA指数57打平Opus 4.8 | 10万张国产芯片服务全球流量 |
| 追赶难度 | 月级更新,几个月可追 | 大规模集群部署需数年积累 |
| 壁垒性质 | 产品能力,可复制 | 基础设施,护城河 |
| 意义 | 阶段性领先 | 结构性突破 |
模型性能可以追赶,今天你57分我53分,下个月我可能就追上来了。但大规模芯片集群的部署能力、互联网络的工程优化、生产级推理服务的稳定性,这些东西的积累不是几个月能追上的。
智谱自己也说得很清楚,"端到端服务性能提升了3倍,硬件效率和单Token成本已达到与主流英伟达GPU相当的水平"。
注意这句话的分量。不是说国产芯片在实验室跑分上追上了英伟达。是说在真实的大规模在线服务场景下,国产芯片的单Token成本已经能跟英伟达掰手腕了。
这是从"能用"到"好用"的分水岭。
接下来会怎样
我自己判断,三件事可能会在接下来几个月发生。
第一,更多国产芯片厂商会走这条路。用真实负载证明自己,而不是靠跑分和发布会。摩尔线程、海光、寒武纪,都可能有类似动作。10万张芯片撑住全球第一模型的流量,这个案例太硬了,硬到可以改变市场叙事。
第二,匿名发布策略会被更多公司效仿。但效果会递减。第一只做匿名是悬念,第五只做匿名就是套路了。而且国际平台可能会调整Stealth模型的规则,避免被"刷榜"。
第三,价格会被进一步打下来。GLM-5.3-Flash把Opus 4.8级别的智能打到四十分之一的价格,同一天阿里Qwen3.8-Flash把训练成本降了近90%。国产模型正在用架构创新而不是烧钱补贴来重构价格体系。这个趋势不可逆。
当然,我也可能看错。国产芯片在大规模在线服务中是否真能长期保持稳定,还有待观察。62T tokens的日处理量是测试期数据,正式上线后的持续稳定性才是真正的考验。而且,国产芯片的具体型号、互联架构的技术细节,目前都没有完整披露。
这件事跟你有什么关系
如果你是AI应用开发者,GLM-5.3-Flash把智能的成本打到了一个新的水位线。Opus 4.8级别的智能,四十分之一的价格。你可以重新算一笔账,很多之前因为成本做不起来的AI应用,现在可能跑得通了。
如果你关注国产芯片,这是一个信号性的时刻。不是跑分,不是发布会,是真实全球负载下的大规模在线服务。国产芯片第一次以"撑住全球第一模型流量"的方式证明了自己。
如果你只是普通用户,记住一件事就够了。过去你用的每一个AI产品背后,大概率跑在英伟达的芯片上。从今天起,有一部分背后跑在了国产芯片上。这个变化正在发生,虽然你可能感受不到。
聊到这里我突然想起一个事。当年台积电从飞利浦的边缘部门,一步步变成全世界芯片制造的咽喉。不是说国产芯片就是台积电。但那个从"不被看好"到"不可替代"的过程,确实有点那个味道。
牛来是谁,一周就揭晓了。10万张国产芯片能走多远,可能需要十年才能看清楚。
但方向,已经对了。
谢谢你看我的文章。
犀牛伯爵 · 记录AI如何改变技术、商业与人的工作方式。