40年没人找到的漏洞,一个免费的中国AI找到了
1986年,互联网还在用拨号上网。
那一年有人写下了DNS协议的一段代码。这段代码后来跑在互联网底层,安静地工作了40年。Windows 95发布的时候它在跑,iPhone问世那天它在跑,ChatGPT上线那天它还在跑。全球超过1000万处公网DNS服务,每天用这段40年前写下的逻辑解析域名。
40年,没有一个人发现里面藏着一个漏洞。
直到上个月。一个AI自己看了看。
这个AI不是GPT,不是Claude。是智谱的GLM-5.3,743B参数稠密模型,中国公司做的。8月28日下午3点发布,同步在HuggingFace开放完整权重,支持BF16和FP8两种精度。
免费下载。
开源前的安全评估里,GLM-5.3总共找到2404个漏洞。那个藏了40年的DNS协议漏洞,是其中最重的一个。
能发现40年没人找到的漏洞,这件事比任何跑分都重。
跑分也得说,因为差距真的小了
AA综合智能指数60分。Claude Fable 5也是60分。GPT-5.6 Sol是61分。
半年前,60分是闭源俱乐部的入场券。你交钱,你用API,你拿到这个级别的智能。不交钱,差10分以上。
现在智谱站在同一条线上,然后把成绩单贴到了网上。
| 测试项目 | GLM-5.3 | 对比 |
|---|---|---|
| AA综合智能指数 | 60 | Claude Fable 5: 60 / GPT-5.6 Sol: 61 |
| Terminal-Bench 3.0 | 28.3 | 上代: 4.6 |
| DeepSWE v1.1 | 66.9 | 上代: 46.2 |
| GDPval-AA v2 | 1769 | Kimi K3: 1682 |
| CyberGym | 84.5% | GPT-5.6 Sol: 83.6% |
| ExploitBench | 54.4% | 上代: 24.4% |
Terminal-Bench 3.0从上代4.6跳到28.3,翻了六倍。DeepSWE v1.1从46.2到66.9。GDPval-AA v2拿到1769,超过Kimi K3的1682。CyberGym 84.5%,超过GPT-5.6 Sol的83.6%。ExploitBench从24.4%到54.4%。
这些数字单独看,你可能会想"又一个刷榜的"。坦率地讲,两年前这么想是对的。那时候有模型在榜单上漂亮,一到真实场景就露馅。但那个40年的DNS漏洞,没法刷。

当最强模型免费,谁该紧张
我一直觉得"国产追上来了"这个说法不对。
不是追上来了。是"追赶"这个概念开始松动了。当第一梯队的分数是60、61、60,谁追谁?当排第一的人把成绩免费送的时候,追赶还有什么意义?
半年前你选Claude,是因为Claude确实比别人强一截。贵,但值。你多付的钱买的是能力差。现在GLM-5.3跟Claude同一档了,免费。你作为开发者,决策逻辑就变了。你不再问"谁更强",你开始问"强出来的那一点,值不值得每个月付那么多钱"。
闭源阵营
Claude Fable 5,GPT-5.6 Sol。API按token收费,权重不公开。你只能用它,不能改它,不能看它怎么工作。
开源阵营
GLM-5.3,Kimi K3。权重免费下载,可以本地部署,可以微调,可以二次开发。能力追平了,获取成本是零。
这个转变比跑分本身重要得多。一个创业团队用免费的开源模型搭出一套跟Claude API差不多的效果,Claude的定价权还能撑多久?不是说Claude不值那个钱,而是当替代品足够好的时候,"足够好"就是"足够致命"。
智谱开源GLM-5.3不是无脑放开。许可协议写得很精准,年营收超过100亿美元的机构如果要对外提供GLM-5.3服务,才需要走安全审查。这个门槛把个人开发者、创业公司、中小企业全部放进来,只把少数巨头挡在门外。
不是天真。是策略。
"当免费的足够好,付费的就必须解释,凭什么贵。"
九十年代Linux刚出来的时候,商业Unix厂商也说开源不靠谱,生产环境不能用。然后Linux用了十年,从"不靠谱"变成了所有云基础设施的底座。不是Linux变强了才被接受,是大家发现够用了就用了,用了就强了。
GLM-5.3站在同一个路口。
40年的漏洞,怎么刷
你想想这件事的重量。
DNS协议是互联网最底层的基建之一。全球1000万处公网DNS服务在用它。40年来,无数安全研究者审过这段代码,没发现问题。一个AI模型,在两周的安全评估里,自己找到了。
Terminal-Bench能靠训练数据刷。DeepSWE能靠针对性优化刷。但发现一个真实的、影响千万级基础设施的零日漏洞,靠的不是记住了多少漏洞模式,是理解了协议的工作原理。
做题和研究之间,差的不止一个数量级。你把全世界的安全漏洞报告喂给一个模型,它可能考试满分。但面对一段40年没人碰过的真实协议代码,它得自己理解这段代码在做什么,理解协议的设计意图,然后找出设计者当年没想到的边角情况。这不是匹配题,是开放题。
开源前安全评估总共发现2404个漏洞。我反复看了这个数字,确认没看错。2404个。不是一个模型在跑分,是一个有研究深度的系统在工作。你把2404个漏洞摊开来看,大部分可能是中低危的代码缺陷,但只要有几个是像DNS这样的协议级零日漏洞,这个模型的安全研究价值就已经跑赢了绝大多数闭源系统。
这次不一样
一个能在40年没人动过的底层协议里找到漏洞的模型,在代码审计、系统运维、渗透测试这些真实场景里的价值,不是跑分能衡量的。模仿可以靠数据,发现只能靠理解。
产业链开始动了
模型发布当天,金山办公宣布Day 0接入。商汤大装置同步提供算力。
Day 0不是随便说的。说明金山办公在模型公开发布之前就完成了适配。发布即上线。这需要双方在发布前就有深度技术协作,不是发完新闻稿再慢慢接。
商汤提供算力这个细节也值得琢磨。一家AI公司发布模型,另一家AI公司提供算力。不是零和竞争,是产业链协同。国产AI公司之间开始形成上下游配合,而不是各自为战。
同日发布的还有GLM-5.3-Flash,320B总参数,A18B激活,首个多模态版本,AA指数57。旗舰加轻量的组合拳,一边打高端跑分,一边打落地成本。你如果做企业级应用,可能不需要743B全量跑,Flash版本推理成本更低,延迟更短,够用就行。智谱在用产品矩阵覆盖不同场景的需求,而不是只靠一个旗舰模型打天下。
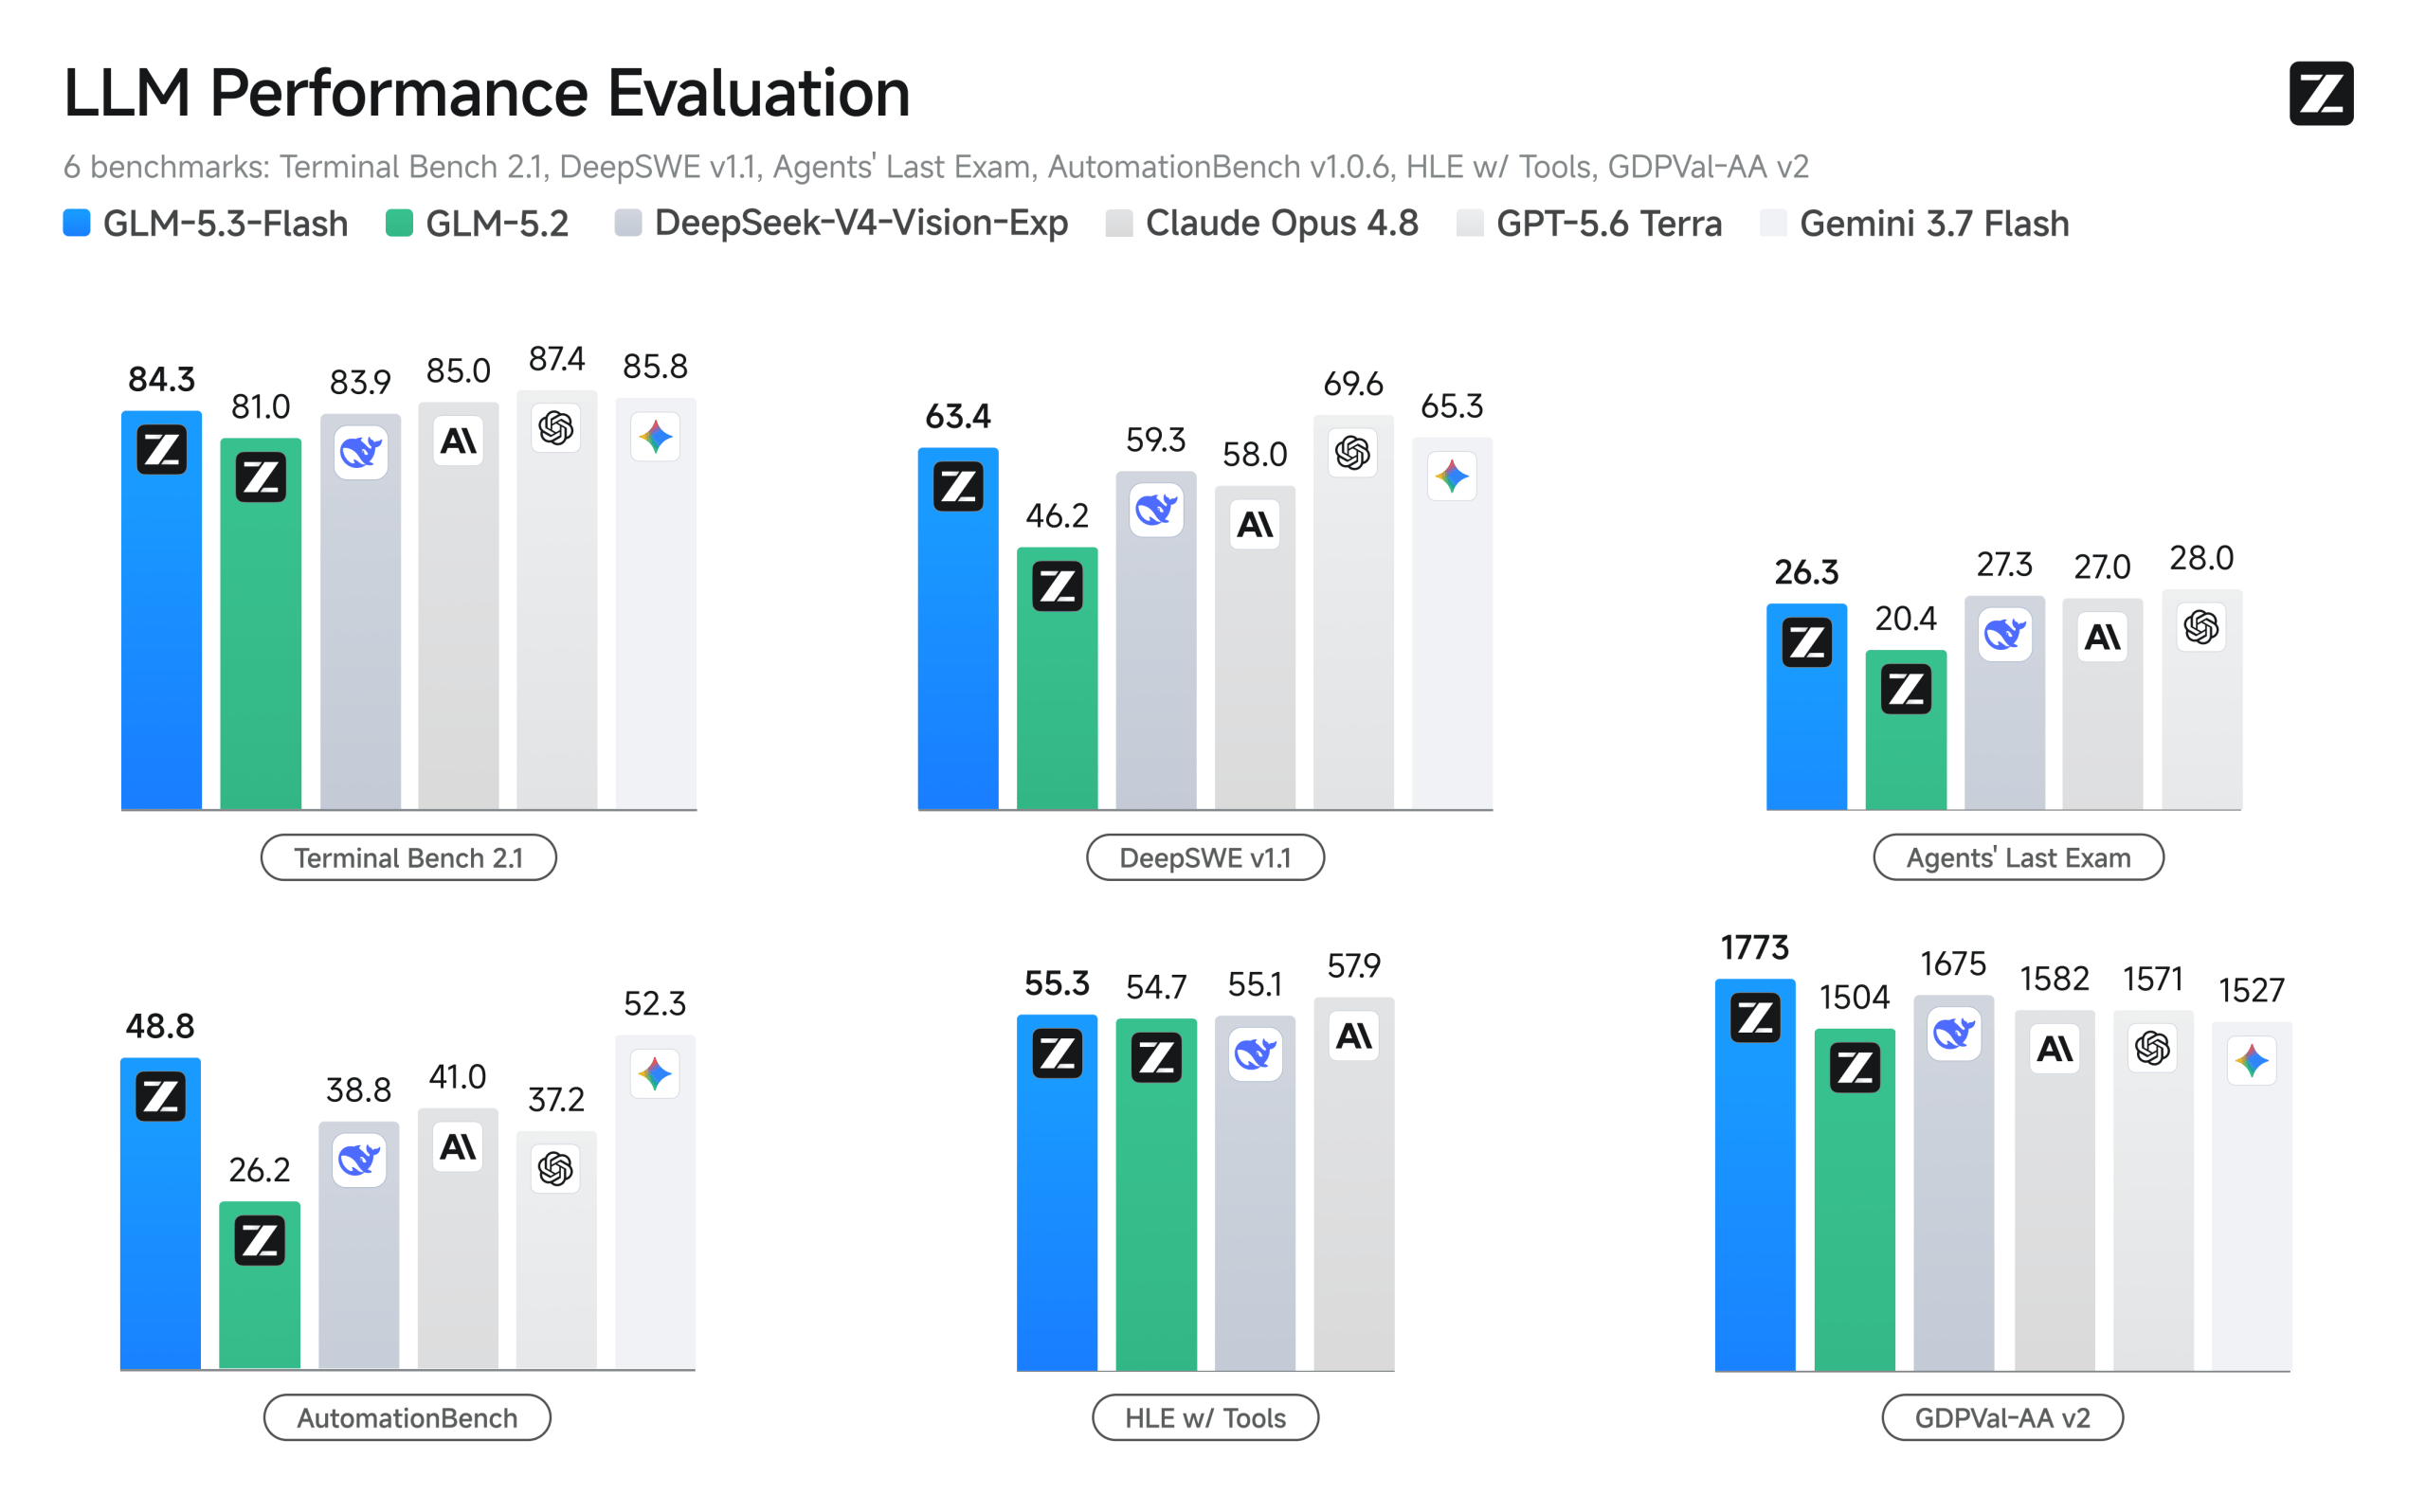
"刷榜"这个质疑,这次可能不成立了
当然有人会说,"跑分不等于实战。""中国模型最擅长刷榜。""真实场景才能见分晓。"
这些话在两年前有道理。那时候确实有模型在榜单上表现优异,一到真实场景就拉胯。刷榜这件事在AI圈不算秘密。
但CyberGym和ExploitBench不是知识问答。它们是agentic任务,要求模型自主规划、执行多步骤操作、处理意外情况。这类任务靠训练数据记忆搞不定。你没法通过在训练集里塞更多安全漏洞的描述来让模型在真实环境中发现一个零日漏洞。要么理解了协议的工作原理,要么发现不了。
那个40年的DNS漏洞是真的。它影响的是真实的公网基础设施。金山办公在发布当天就完成接入,如果GLM-5.3只是跑分好看,金山不会在发布前就投入工程资源做适配。企业用真金白银和工程师的时间投票,比任何跑分都有说服力。
接下来会怎么走
我目前的看法是这样的,也可能我错了。
闭源厂商会把竞争焦点从"谁更强"转向"谁的生态更完善"。Claude有Anthropic的整套企业级工具链,GPT有OpenAI的消费级入口。这些东西不是靠一个开源权重就能替代的。能力追平了,但产品层、生态层的差距还在。
但开源模型会加速蚕食中长尾市场。当你有一个免费且够强的模型可以自己部署,很多场景没必要为API付费了。创业公司用GLM-5.3自己搭一套,成本从按量计费变成一次性硬件投入,账算得过来。
那个年营收100亿的门槛也值得留意。智谱在用开源建立影响力,同时给自己留了商业化的后路。先让所有人用起来,再从大规模商用中收费。
对你
如果你是开发者,现在可以认真考虑在技术选型里加一个开源选项了。不是因为情怀,是因为真的够用了。743B参数的稠密模型,跑分跟Claude打平,能下载,能部署,能改。
如果你做AI产品,模型能力的获取成本正在快速趋近于零。你的竞争力不能再靠"我们用了GPT"来定义,得靠你拿模型做了什么别人做不了的事。模型会越来越便宜,越来越开放,但用模型解决具体问题的判断力和工程能力,不会自动变便宜。
40年前,有人写了一段代码,没人发现里面的漏洞。
40年后,一个免费的AI发现了它。
这个故事比任何跑分都重。