一个没有发布会的模型,拿下了全球编程第一
9月2日。一个普通的周二。
没有发布会,没有红毯,没有直播。阿里千问团队在 CodeArena 榜单上更新了一个分数。
那个分数停在了 1691。全球第一。
不是 GPT-5.6。不是 Claude Opus 5。是 Qwen3.8-Max-0902。
我自己看到这个数字的时候愣了一下。因为就在 47 天前,7 月 16 日,月之暗面的 Kimi K3 以 1679 分拿下同一个榜单的第一,把 Claude Fable 5 的 1631 分甩在身后。那是国产模型第一次在 CodeArena 前端编程榜上登顶。
现在,另一个国产模型又超过了它。47 天,换一次王座。
不是偶然。
1691 是什么概念
CodeArena 不是你熟悉的那种跑分榜。它不用 LeetCode 算法题,不用 HumanEval。它用 217 个工业级用例,从真实 GitHub PR 到企业级题库,从 Figma 插件开发到 Next.js SSR 诊断。开发者提交真实场景任务,匿名模型同台竞技,人类盲测投票。
说直白点,这不是考你会不会写排序算法。是考你能不能从零开始交付一个能用的东西。
Qwen3.8-Max-0902 在这个榜单上拿了 1691 分。比它自己的上一版提高了 22 分,从 1669 跳到 1691。比第二名 Claude Opus 5 领先 37 分。
37 分在 CodeArena 是什么概念。是"不是一个档次"的差距。在竞技场盲测中,超过 10 分的差距就足以让人类评审明确感知到质量差异。37 分,是碾压级别的断层。
| 排名 | 模型 | 分数 | 来源 |
|---|---|---|---|
| 1 | Qwen3.8-Max-0902 | 1691 | 中国 · 阿里 |
| 2 | Kimi K3 | 1679 | 中国 · 月之暗面 |
| 3 | Claude Opus 5 | 1654 | 美国 · Anthropic |
说真的,一个中国模型在编程榜单上领先 Claude 37 分,放在一年前是不可想象的。去年同一时间,CodeArena 的前五名里一个中国模型都没有。
价格才是真正的杀招
1691 分是天花板。但让我更在意的是另一个数字。
$5
每百万 Token,5 美元。这是 Qwen3.8-Max-0902 的 API 均价。
我把它和几个主要对手放在一起看。某美系闭源旗舰报价 18.7 美元每百万 Token。某港产明星模型标价 11.3 美元。Qwen3.8-Max-0902,5 美元。
闭源旗舰
$18.7 / 百万 Token
CodeArena 1654 分
Qwen3.8-Max-0902
$5 / 百万 Token
CodeArena 1691 分

在 CodeArena 的帕累托前沿图上,Qwen3.8-Max-0902 是性价比最优的那个点。所有价格高于 5 美元的模型,分数都没有它高。所有分数比它高的模型,不存在。同样性能花更少的钱,同样价格拿到更强的模型。帕累托前沿上的最优解,就是开发者最该选的那个。Qwen3.8-Max-0902 把这个点钉死了。
这个价差不是小数目。对于一个月消耗 10 亿 Token 的企业来说,用闭源旗舰每月花 18700 美元,用 Qwen3.8-Max-0902 每月花 5000 美元。一年下来差 16 万美元。够雇一个全职工程师了。当模型能力接近甚至反超的时候,价格就是决策的最后一根稻草。
这个定价策略不是拍脑袋。它背后是一套完整的打法。把价格压到对手的零头,同时分数压过对手,然后用生态绑住开发者。
坦率地讲,中国大模型公司已经把这件事玩明白了。不是靠更便宜抢市场,是靠又便宜又强来重新定义什么叫"值"。
不是模型更大了,是训练方式变了
很多人第一反应是,Qwen3.8-Max-0902 是不是又堆了更多参数。
不是。
2.4 万亿总参数,激活约 950 亿。稀疏 MoE 架构,混合注意力。这些数字和 8 月 3 日首发的 Qwen3.8-Max 基座完全一样。支持 100 万 Token 上下文,也没变。
变的是什么。后训练。
这次 0902 版本的核心更新是专项后训练,聚焦两个方向,Coding 和 Cowork。基座模型没有动,提升全部来自后训练阶段的针对性优化。
这里的信号比分数更重要
模型竞争正在从"谁的参数更大"变成"谁的后训练更精准"。Qwen3.8-Max-0902 证明了一件事,基座能力到了一定水平之后,真正的差异化在后训练。2.4 万亿参数的基座不动,靠后训练把分数推高 22 分,这个效率比堆参数高得多。
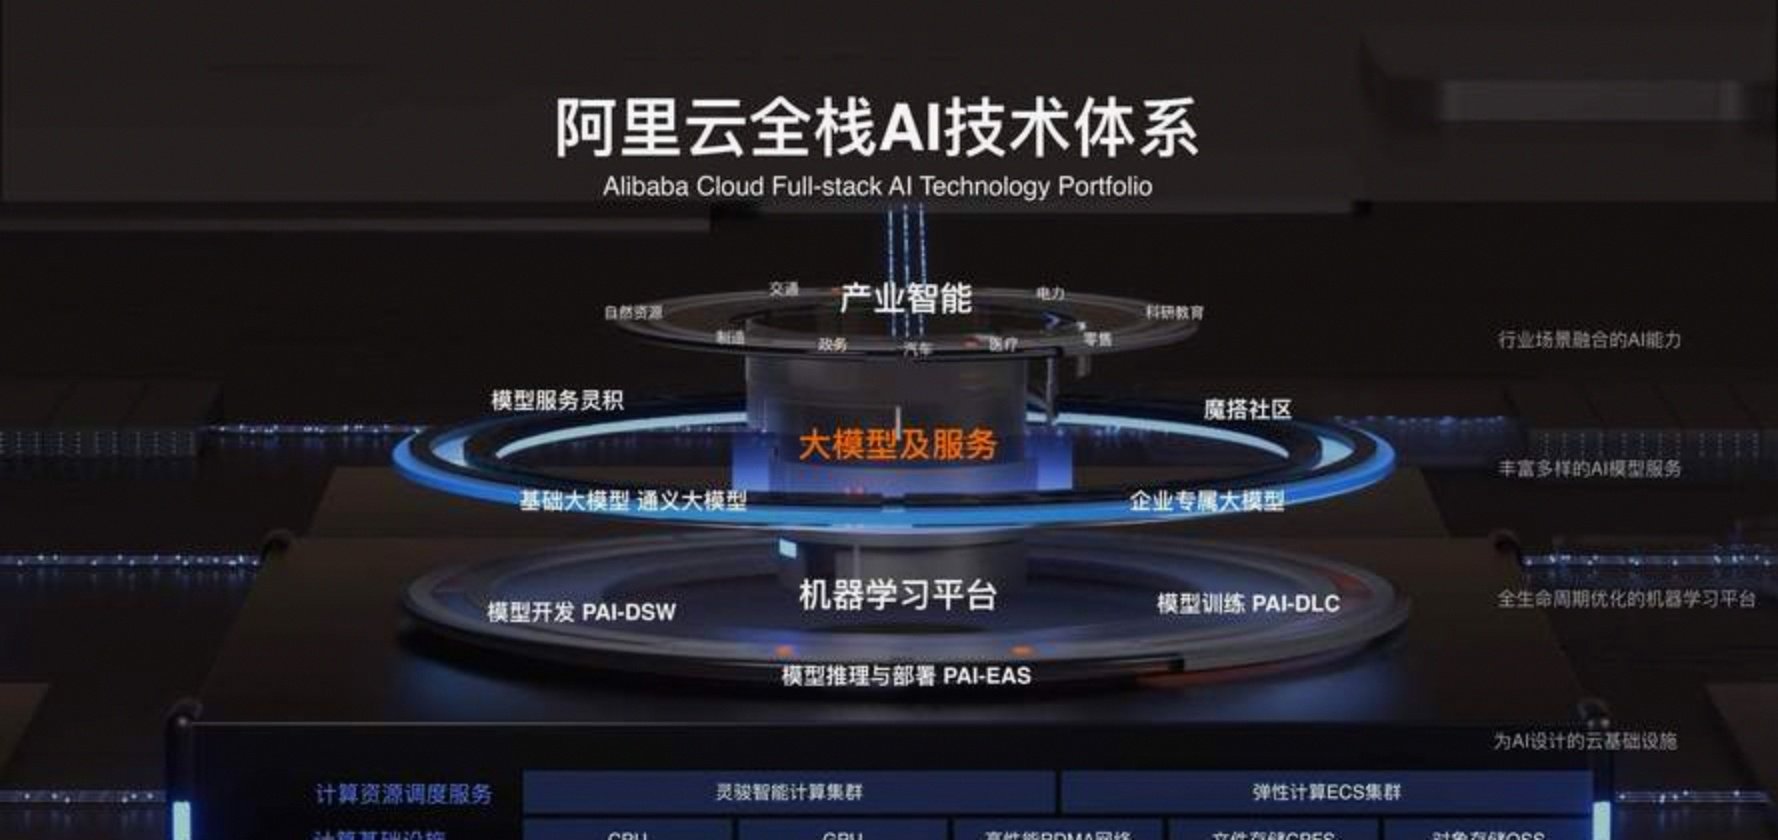
后训练的投入产出比远超堆参数。训练一个更大的基座需要数万张 GPU 跑几个月,成本上亿美元。后训练专项优化只需要在已有基座上做针对性数据增强和强化学习,成本降一到两个数量级。用百分之一的成本拿到可感知的能力提升,这笔账谁都会算。
这一点和整个行业趋势吻合。今年 5 月发布的 Qwen3.7-Max 已经在 Agent 方向做过一次后训练专项突破。当时它甚至没接触过真武 M890 芯片,就靠自主编程和超过 1000 次工具调用,在 35 小时内完成了推理内核优化。模型学会了自己优化自己的运行环境,这件事的意义比任何一个跑分都大。8 月 13 日开源的 Qwen3.8-2.4T-A95B 进一步验证了基座能力的上限。0902 版本是在同一个基座上,把编程和协作两个维度单独拉出来强化。
结果就是,在智能体编程能力上出现了明显的涌现。Qwen3.8 可以从一个空文件夹开始,读代码、写代码、跑测试、修 Bug,完成一个真实项目的交付。从分析到实现到部署,全流程自主。
这不是吹牛。CodeArena 的 217 个用例就是 217 个真实交付场景。一个模型能自主读完整个项目代码,梳理业务逻辑,定位漏洞,编写单元测试,甚至自动执行终端命令调试程序。这些不是实验室模拟,是真实开发者每天会碰到的工作。1691 分就是人类开发者在这些真实任务里投出来的最好用。
王座一个月换一次
但我不想把这件事写成一篇捷报。
坦率地讲,CodeArena 只是一个前端编程榜单。它测的是前端,不是全栈,不是后端,不是系统级编程。在前端这个细分领域拿了第一,不等于编程能力全面第一。
而且,这个榜单的竞争节奏快得吓人。
47 天,王座从 Kimi K3 传到 Qwen3.8-Max。下一次换人,可能更快。
中国大模型的发布节奏已经从按季度算压缩到了按周算。这种速度的背后是算力基础设施的成熟、训练工程的经验积累,以及一个被很多人忽视的因素,中国开发者社区的真实反馈在反哺模型迭代。模型上线不是终点,是下一轮训练数据的起点。
我一直觉得,中国大模型公司之间的这种"接力赛"才是最值得关注的信号。不是某一家在某一天拿了第一,是不同的中国公司轮流拿第一。Kimi K3 拿过,Qwen3.8-Max 拿过,GLM-5.3 在别的维度拿过。这种交替领先说明一件事,中国的模型能力不是某一家公司的突破,是整个生态的上升。
去年同一时间,国产模型在 CodeArena 上的最高排名还在十名开外。一年之内,前三名里两个是中国公司。不是追赶,是交替领跑。这种节奏只有一种解释,中国大模型的后训练能力、数据工程能力和工程化部署能力,已经形成了体系化的竞争力,不是靠某一个天才的灵光一闪。
下一个战场不在榜单上
CodeArena 的 1691 分是一个结果。但更重要的是它背后的分发能力。
Qwen3.8-Max-0902 已经接入四个端,千问 AI 平台 API、千问办公、Qoder、千问 App。不是一个入口,是四个入口。从今天开始,任何使用千问生态的开发者,拿到的就是全球编程第一的模型。
"Qwen3.8 可以从一个空文件夹开始,完成一个真实项目的交付。"
同时,中国开源 LLM 的月度 Token 消耗量也在印证这个趋势。TOP3 全是国产,DeepSeek V4 Flash 月消耗 21.5 万亿 Token,小米 MiMo V2.5 消耗 20.5 万亿,Minimax M3 消耗 17.1 万亿。增速分别是 42%、198%、177%。
这些数字说明什么。开发者用脚投票。不是看跑分选模型,是真的在用。
还有一个数据。Hugging Face 的报告显示,千问系列开源模型全球下载量突破 30 亿次,超过 Meta 的 Llama 和 Google 的模型。今年 1 到 7 月下载量 20.45 亿次,全球第一,是美国 Google 模型下载量的 5 倍。千问已经开源超过 460 个模型,催生出 30 万个衍生 AI 产品。这不是一家公司的胜利,是一种生态策略的胜利。模型开源,生态繁荣,开发者习惯养成,然后反馈数据反哺下一代模型训练。飞轮转起来了。
日本的制造企业已经开始在生产环境用千问。日方团队的负责人说了一句话,"Qwen 已经完全够用了。"这家企业本身就是一家日本国产 AI 开发公司的投资方。高层押注国产 AI,一线技术团队却选了千问。决策层和执行层给出了不同的答案,技术实力比战略叙事更有说服力。
当全球开发者在用你的模型,当日本企业在生产环境选你的模型,当你在编程榜单上拿了第一还只收对手零头的价格,竞争的维度已经变了。
不是谁更聪明的比赛了。是谁更便宜、更强、更开放的系统战。
9 月 2 日没有发布会。但 1691 分会说话。中国 AI 不再需要发布会来证明自己了,分数和价格会替它说话。
谢谢你看我的文章。