Flash干掉了Pro,DeepSeek自己卷自己
9月10日中午12点。DeepSeek的开发者群里弹了一条通知。
没有发布会,没有预热海报,甚至没有一篇正式的官方博客。就一行字,V4.1 Flash上线了。
但群里瞬间炸了。
因为这个名叫Flash的"小模型",干掉的不是别人,是DeepSeek自家的旗舰Pro。官方原话是,V4.1 Flash在性能、费用、速度、总用时上已全面超越V4 Pro。
自己卷自己。而且卷得毫不留情。
你以为这只是又一个新版本发布?我当时也是这么想的。直到我看到了那个架构图。
这个Flash不是GPT,不是Claude。是DeepSeek。一家中国公司。
说真的,DeepSeek这次干的事,在整个AI行业里找不到第二个先例。把自己的旗舰模型Pro下线,用一个定位更低的Flash来替代,而且性能还更强了。
就好比你开了一家餐厅,招牌菜是和牛套餐,突然有一天你说,我们出了个盒饭,味道比和牛还好,价格只有三分之一,以后和牛不卖了。
这不是疯狂。是底气。
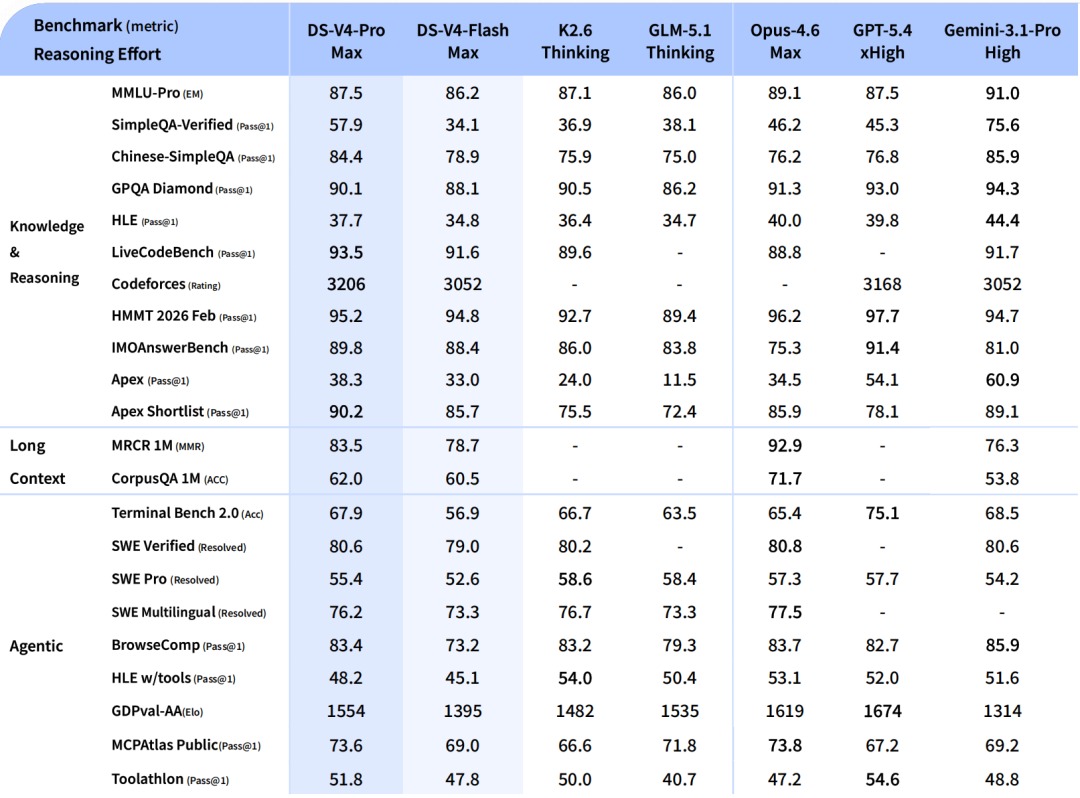
来看几个数字。V4.1 Flash的GPQA Diamond得分90.9,Codeforces竞赛评级3471,Terminal-Bench 2.1拿到90.6。
对比V4 Pro,Terminal-Bench从87.9涨到90.6,CyberGym从83.3跃到88.1,Codeforces从3348到3471。最夸张的是Terminal-Bench 3.0,从11.8直接跳到30.0,提升超过150%。
这些数据来自DeepSeek官方API更新日志,9月10日发布。
| 测试项 | V4 Pro | V4.1 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 87.9 | 90.6 |
| CyberGym | 83.3 | 88.1 |
| Codeforces Rating | 3348 | 3471 |
| Terminal-Bench 3.0 | 11.8 | 30.0 |
但跑分只是表面。真正让我愣了一下的,是那个新架构。
V4.1 Flash采用了全新的Causal-Encoder-Decoder结构,552B总参数的MoE模型。关键在于"非对称",输入侧只激活8B参数,输出侧激活16B。
这跟Agent任务的特点有关。Agent需要读几万token的上下文、工具返回和代码仓库,然后生成几百token的输出。输入远大于输出。DeepSeek直接把输入侧的计算量砍到最低,专为Agent场景设计。
这种架构思路,在全行业里是头一个。
我有时候觉得,国内AI公司总被拿来跟OpenAI比。比参数,比跑分,比融资。但DeepSeek这次走了一条连OpenAI都没走过的路。
它不是在追谁,它在定义自己的赛道。
坦率地讲,Agent不是新概念。OpenAI有Assistants API,智谱有AutoGLM,月之暗面有Kimi探索版。但大部分模型还是用"对称架构"处理Agent任务,输入输出用一样的算力。
这就像用卡车送货和送信,不管装多少都开同样大的车。DeepSeek的非对称设计,等于给送货和送信配了不同的车。
不是靠跑分。是靠场景。
再看成本。KV Cache比上一代大幅压缩,HBM需求降到四分之一,SSD需求降到八分之一。Agent场景里,缓存命中费用往往占总成本的大头。缓存压缩了,成本自然就下来了。
API降价也来了。空闲时段输入缓存命中0.02元每百万token,比之前降了60%。输出4元。高峰时段翻倍。9月10日12点生效。
你想想那个做AI Agent创业的团队。以前用V4 Pro,高峰时段输出费用贵到肉疼。现在同样的模型能力,闲时只要4元。这不是降价,这是换了个价位段。
我自己看到这个价格的时候愣了一下。
不过,主流报道里有一个被忽略的细节。所有人都在说"Flash超越Pro",但没有人问,Pro才发布多久?
答案是,不到一个月。V4 Pro正式版8月13日上线,到V4.1 Flash发布,中间只隔了28天。
28天。旗舰就变成了"前任"。
这背后只有一个解释。DeepSeek在赶时间。赶什么时间?科创板IPO。
9月9日,21世纪经济报道确认,DeepSeek已委托中信证券筹备科创板上市,中信已入场尽调。消息发布的时间点,恰好是V4.1 Flash内测结束、正式版上线的前一天。
技术突破和资本运作,双线并进。
V4 Pro下线后,原来的Pro用户全部自动路由到Flash。腾讯的WorkBuddy、CodeBuddy,开源框架OpenCode已经全量接入。
这些平台每天的调用量加在一起,是一个天文数字。Flash能不能扛住这个流量,接下来两周是关键期。如果扛住了,DeepSeek在Agent推理市场的份额会再上一个台阶。
如果你正在选大模型API,给你三个判断标准。
第一,看你的任务是不是Agent类型,如果是,V4.1 Flash的非对称架构天生为你省成本。
第二,看缓存命中率,DeepSeek的缓存命中价格极低,但如果你的prompt前缀不稳定,缓存不命中价格会高得多。
第三,看使用时段,闲时价格只有高峰的一半,把批量任务放到凌晨跑,账单能砍一半。
记住这个数字,0.02元。每百万token缓存命中输入,闲时。这是DeepSeek V4.1 Flash的价格。
国产大模型的价格战打了一年,从OpenAI到智谱到千问,你方唱罢我登场。但DeepSeek这次不是在打价格战。它是在用MoE架构创新把价格战的维度升级了。不是"我便宜",是"我便宜是因为我架构更好"。
我一直觉得,今年的国产大模型赛道,真正的分水岭不是谁跑分第一。是谁先把AI Agent从概念变成日常工具。
DeepSeek赌的是,Agent时代的基础设施,不需要最贵的模型,需要最懂场景的模型。
Flash就是那个答案。
说真的,我更期待的是V4.1 Pro。如果Flash已经这么猛了,Pro会强到什么程度?DeepSeek没有说。但按这个节奏,可能也不用等太久。
这步棋很狠。
你遇到过这种情况吗?用着用着模型就被下线了。评论区聊聊你的经历。
觉得有用,转发给正在选AI模型的朋友。建议收藏,下次选模型的时候用得上。
更多AI产业深度观察,关注专业网站 犀牛伯爵 rhinocount.cn
谢谢你看我的文章。